游戏服务器工程实践六:lua cpu 和 heap profiling
游戏服务器时常需要做一些 profiling 工作,c/c++ 部分可以使用 gperftools(Google Performance Tools)进行 profiling,而 lua 并没有一个业界权威的工具,在 github 找到的也都不能满足我的要求。
于是我自己做了一个项目 https://github.com/antsmallant/luaprof,实现了想要的效果:开销低,又能相对精确地捕捉到较大的热点。
本文主要介绍 profiling 的机制,以及 luaprof 的功能和设计。luaprof 虽然大部分是 ai coding 出来的,但其思想是经过比较长期的摸索和实践才得来的,也在生产项目上得到了实践。对于大热点的采样挺准的,并且开销很低,远低于那种基于 tracing 机制的 profiling 库。
我们这里说 heap profiling,是比较精确的说法,因为我们确实只是对堆(heap)内存进行 profiling 而已,并不涉及栈内存。
1. profiling 有哪几种机制?
首先说一说 profiling 的机制,对 CPU profiling 而言,常见的数据采集方式有两类:sampling(采样)与 tracing,后者在有些地方也称为基于事件的插桩(instrumentation-based profiling)。
GNU 的官方 gprofng 手册直接有一节叫 “Sampling versus Tracing”:它把 sampling 的对立技术称为 tracing,并定义为“向目标程序插入特定调用来采集信息”。
sampling:周期性记录当前 PC 或调用栈,结果是统计意义上的热点分布。
tracing:通常是利用插桩(instrumentation)方式,在函数调用、返回等事件发生时执行 hook,精确记录调用次数和持续时间。
tracing 和 instrumentation 的关系可以这样理解:
| 词 | 它描述什么 |
|---|---|
| instrumentation(插桩) | 怎么取得事件:在函数入口/退出、系统调用、业务点插入或启用 probe/hook。可静态编译插桩、动态二进制插桩、VM hook 等。 |
| tracing(追踪) | 怎样记录和观察事件:通常保留带时间戳、顺序、参数的事件流。它常由 instrumentation 产生。 |
相关资料:
- GNU gprofng:Sampling versus Tracing
- GNU gprof:采样误差与函数插桩实现
- GCC:Program Instrumentation Options
- Lua 官方手册:
lua_sethook的 call / return / line / count 事件
2. github 上若干 lua profiling 项目
github 上有不少做 lua profiling 的项目,但研究下来,都有一些局限,不能满足我的要求。
2.1 plua
项目地址:https://github.com/esrrhs/pLua 。
局限1:不能准确统计 cfunction
见这个issue:无法抓到 c 栈帧 #9。
问题在于它是使用 LUA_MASKCOUNT 去 sethook 的,采样时钟到的时候,要等下一个 vm 指令去抓栈,所以当 cfunction 是调用栈的叶子节点并且它不回调 lua 时(往往是这样)是抓不到的。比如在 lua 中调用 tonumber / print 这类 cfunction 函数。
如果 cfunction 执行时间很长,期间 handler 只是重复设置 hook,没有累计待处理的 tick,多个采样时刻最终可能只形成一个样本。即使补上 tick 计数,也只能保留采样次数和时间权重,无法仅凭返回 Lua 后获取的调用栈,恢复这些 tick 原本对应的 CFunction 归因。
对应的实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
static void SignalHandlerHook(lua_State *L, lua_Debug *par) {
    lua_sethook(L, 0, 0, 0);

    LLOG("Hook...");

    if (gRunning == 0 || (gSampleCount != 0 && gSampleCount <= gProfileData.total)) {
        LLOG("lrealstop...");
        lrealstopsafe(L);
        return;
    }

    CallStack cs;
    get_cur_callstack(L, cs);

    gProfileData.callstack[cs]++;
    gProfileData.total++;
}

static void SignalHandler(int sig, siginfo_t *sinfo, void *ucontext) {
    lua_sethook(gL, SignalHandlerHook, LUA_MASKCOUNT, 1);
}
局限2:不支持多线程
其实有2个问题:
- 用了进程级的定时器,采样时钟按整个进程的 cpu 时间推进,但采样又只针对全局 gL,无法隔离目标 lua 线程的消耗,所以如果是多线程那么统计会很不准。
- 多线程下可能会出现崩溃,见这个 issue:接入到lua 服务器,崩溃 #8 。问题在于信号到达时可能是 B 线程处理,而 lua 在 A 线程,B 线程直接设置 A 线程中的 gL hook,可能产生数据竞争和崩溃风险。
它的实现是:
- 全局只有一个
gL、一个gRunning、一个SIGPROFhandler。 - 使用
ITIMER_PROF作为周期定时器,它会按整个进程的用户态与内核态 CPU 时间推进,而不是某个 Lua VM 所在线程的 cpu 时间。 - 这个定时器每次到期产生
SIGPROF( man7setitimer(2))信号,信号可能在别的线程到达,但它仍对那个全局gL设置LUA_MASKCOUNThook。
2.2 lsg2020/luaprofile
项目地址:https://github.com/lsg2020/luaprofile 。
这个更早是追溯到 https://github.com/lvzixun/luaprofile 。
lsg2020 另外有个项目: https://github.com/lsg2020/swt ,也是基于 https://github.com/lsg2020/luaprofile 去做的一个火焰图。
局限:逐次调用追踪,开销随调用频率增加
luaprofile 使用 tracing 机制,在函数调用和返回时执行 hook,记录耗时、调用次数和调用路径。对于大量短函数调用的负载,这些额外操作可能造成显著开销,并影响测得的耗时分布。
所以它并不能满足我希望低开销、持续观察 cpu 热点的目标。
2.3 spin6lock/skynet_systemtap_set
项目地址:https://github.com/spin6lock/skynet_systemtap_set。
局限:可能出现较大统计偏差
当前这个实现只是采样对于 c lua api 的调用,如果一个运行1秒的纯lua函数只调用了几次 api,而1个运行100毫秒的lua函数调用了几百次api,则统计结果完全不准。
理论上,用 stp 或 ebpf 也能做到接近我这次做的 luaprof 的统计精度,但工程实现难度会很高,完整实现下来比 luaprof 费劲得多。
ebpf 能提供按 cpu 时间触发的采样,用 perf_event_open 指定线程的 tid、设 cpu = -1,事件会跟随线程在不同 cpu 上运行;可设置采样频率,再把 ebpf 程序挂到这个 perf event 上。ebpf 也能读取用户态数据。难点在于把采样正确还原成 lua 调用栈,并在 skynet 的 worker 之间持续识别目标 service。
3. 为什么 sampling 机制能够 work?
sampling 就是用少量观测估计整体分布,背后是概率论和统计学中的抽样估计和大数定律。样本越多,随机误差通常越小。
能解决什么问题
- 发现稳定的大热点。
不能解决什么问题
- 锁相问题。如果采样频率是固定的,则可能遇到锁相的问题,比如某个周期执行的函数,刚好不在采样频率上,那么即使它频繁发生,也不会被采样到。样本多只能压低随机误差,不能自动消除系统偏差。
- 稀有事件。如果某状态只占0.1%的时间,那么采样1000次,那么它仍有37%的概率不被看到。
4. luaprof 介绍
4.1 接入与使用
luaprof 项目接入指南 ,里面已经包含了接入和使用说明了,也可以直接看这个 example 代码: luaprof/blob/master/examples/thread_vm/profile.lua 。
采样模型与结果解读 包含了使用方法和结果解读方法,比如 api 的使用,比如使用 pprof 生成各种结果报告。
需要指出的是,为了实现安全的采样,对 lua 源码做了一些小修改,luaprof 对于 lua 近期的各个版本都做了相应的 patch,可以直接使用,如果是旧一些的版本,就需要参照新版本的 patch 进行相应的修改。
skynet 的 lua 源码也同样需要做类似的修改,luaprof 也有相应的 patch。
使用很简单,就几个 api:start , stop, write,比如 cpu profile 就这样:
启动
1
2
3
local cpu_recorder = profile.cpu.start({
	sample_hz = 100, -- 100Hz,采样周期约为 10ms CPU 时间
})
停止并写结果
1
2
3
local cpu_result = cpu_recorder:stop()
local save_path = "xxx_cpu.pb.gz"
cpu_result:write(save_path)
4.2 核心功能
| 核心功能 | 能回答的问题 | 主要能力 |
|---|---|---|
| CPU 采样 | CPU 主要消耗在哪里? | 按线程 CPU 时间采样,区分 Lua、CFunction、GC 和 host 状态,保留 Lua 调用栈与行号 |
| 内存分配采样 | 哪些调用路径产生了大量分配? | 估算累计分配字节数 alloc_space 和分配次数 alloc_objects |
| 存活内存统计 | 本次采集期间分配的内存,哪些在停止时仍未释放? | 开启 track_free 后,统计 inuse_space 和 inuse_objects |
| Skynet service 分析 | 指定 service 的热点是什么? | 跟随 service handle 跨 worker 迁移,排除其他 service、排队和 sleep 时间 |
| 结果分析与质量检查 | 如何查看热点、判断结果可信度? | 导出 pprof、folded stacks,生成火焰图,并提供丢样、溢出、截断等统计 |
CPU 和 memory recorder 可以同时运行,也可以独立启动、停止。停止后得到冻结的 result,再通过 stats() 查看统计、通过 write() 导出。
下文会使用 pprof 生成报告,也可以在这个文档找到详细用法: 采样模型与结果解读 。
1、cpu 采样支持传统的每线程一个 lua vm 的
说明:
- 允许线程中有多个 lua VM ,但同时只能有一个 lua VM 在做profiling,目前暂时还没遇到传统项目是每线程多 vm 的,遇到了再说吧,改造难度中等。
- skynet 除外,skynet 用了特殊的做法,支持按 service 采样。
可以按函数归因:
1
2
make example-thread-vm
go tool pprof -top build/thread-vm-cpu.pb.gz
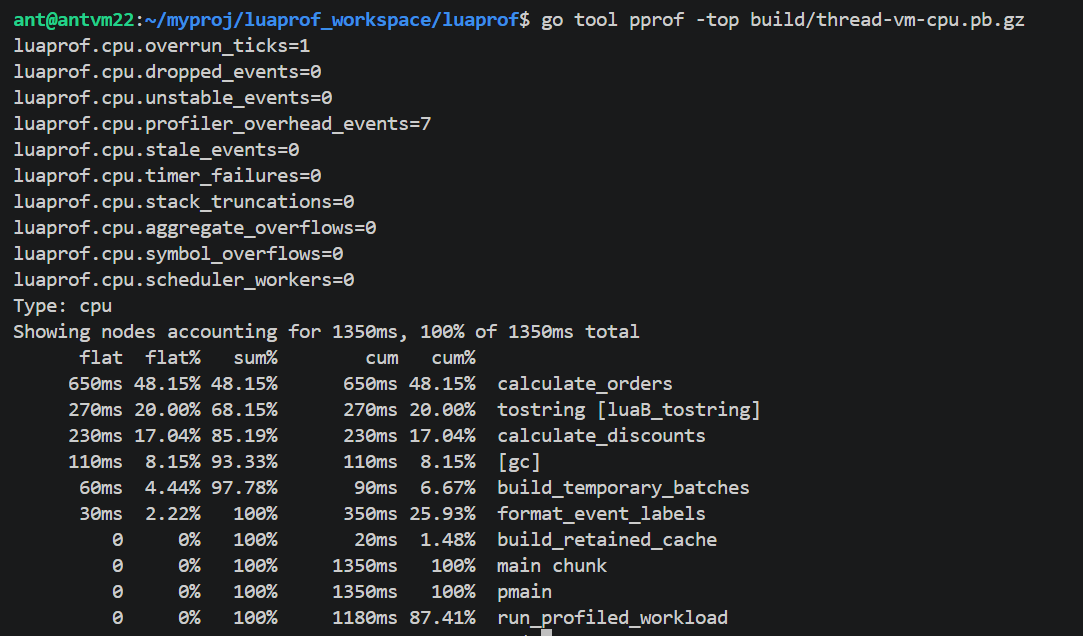
flat% :函数本身的消耗。
cum% :函数本身加上它的子调用的消耗之和。
sum% :从第一行到当前行的所有消耗之和。
默认是按 flat 排序的,也可以指定按 cum 排序,这样:
1
go tool pprof -top -cum build/thread-vm-cpu.pb.gz
也可以按行归因,但这会显得过细:
1
go tool pprof -lines -top build/thread-vm-cpu.pb.gz
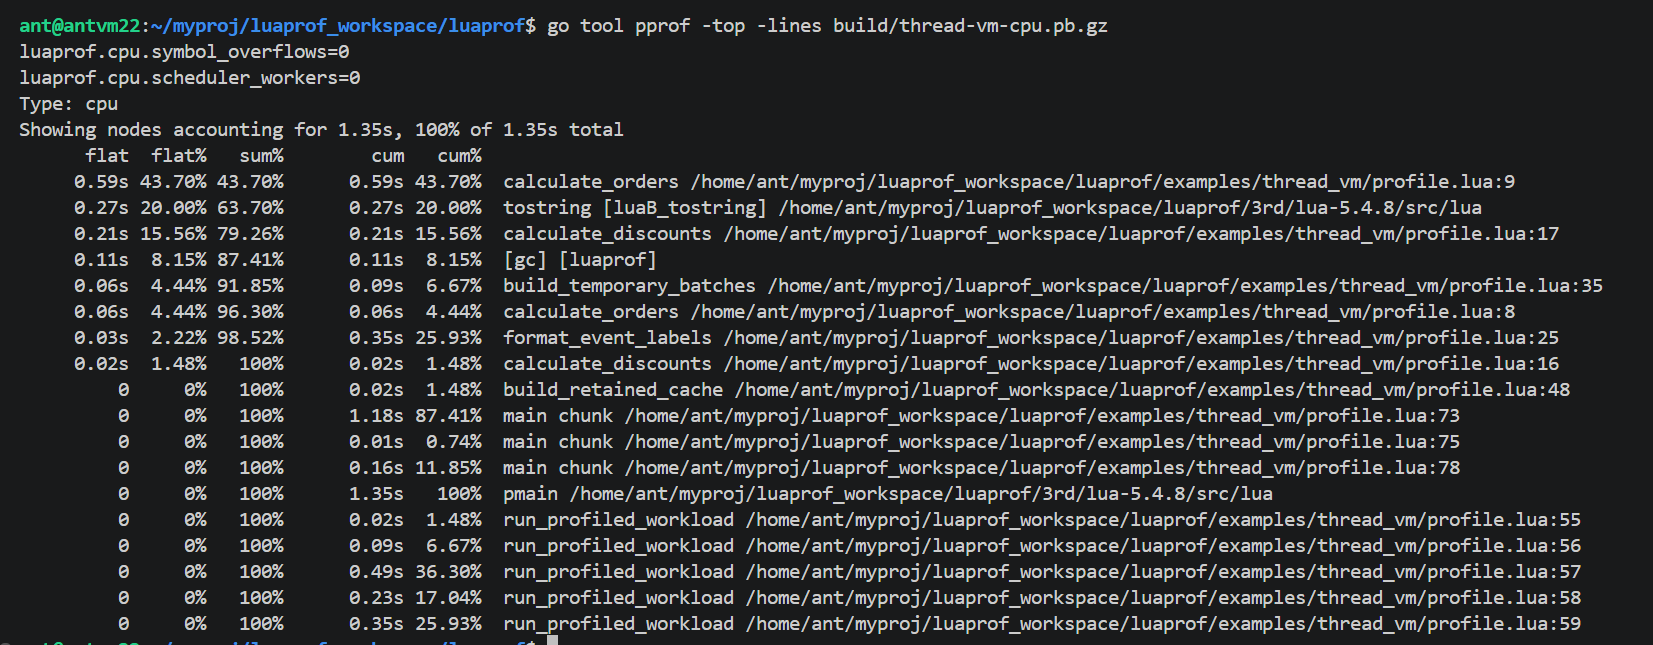
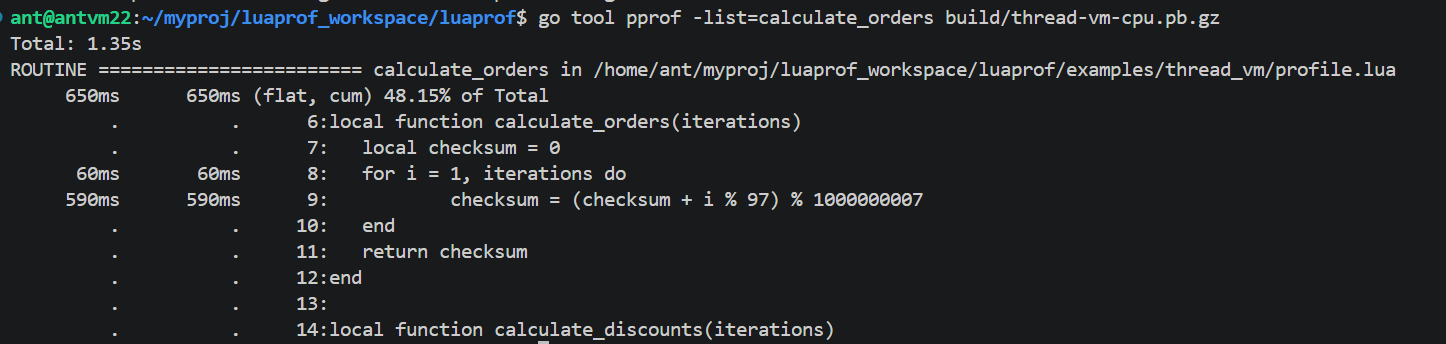
其实大部分情况下用 -top 去抓热点,然后用 -list 展开具体某个热点就行,不需要用 -lines 的。比如上面 图1-1 抓到的 calculate_orders 函数,就可以 -list 展开它,得到内部开销情况:
1
go tool pprof -list=calculate_orders build/thread-vm-cpu.pb.gz
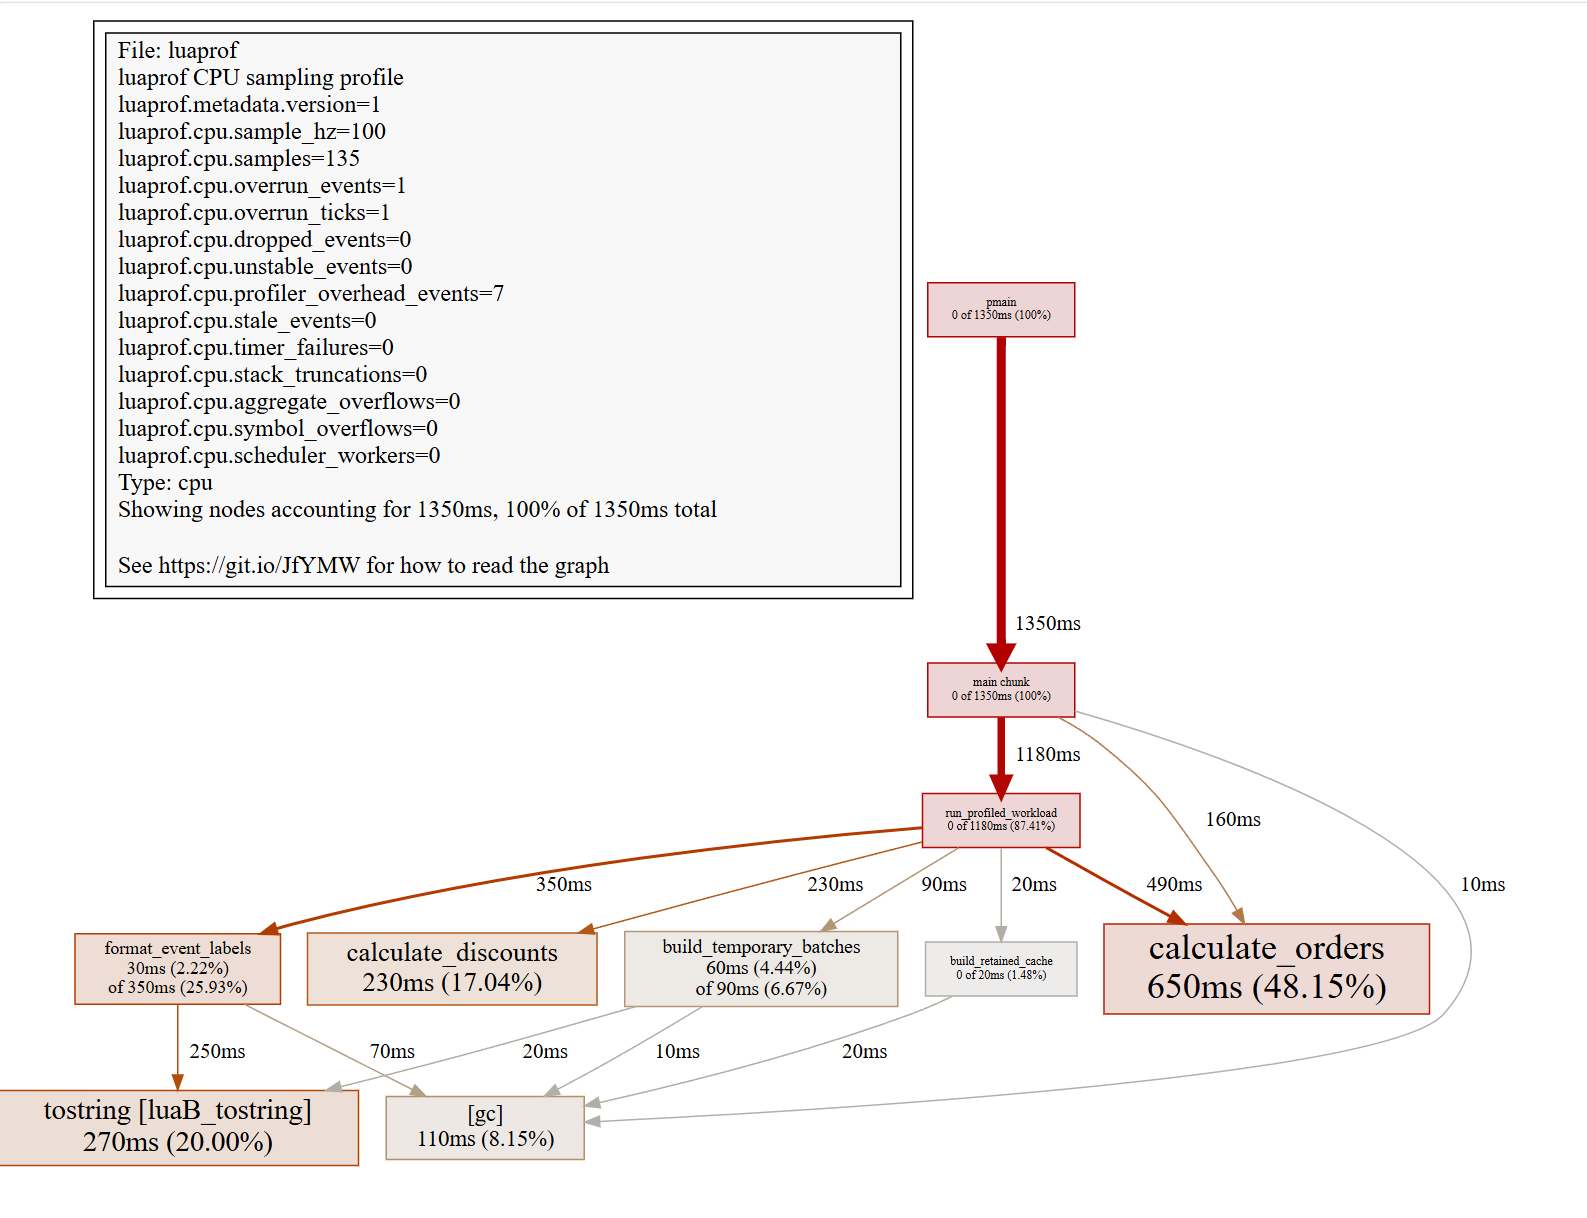
还可以直接使用 svg 图,更直观:
1
go tool pprof -svg build/thread-vm-cpu.pb.gz > build/thread-vm-cpu.svg
生成后直接用浏览器打开:
2、cpu 采样也支持 skynet 按 service 采样
运行示例:
1
2
make example-skynet
go tool pprof -top build/skynet-cpu.pb.gz
skynet example 是这个 service : luaprof/examples/skynet/luaprof_demo.lua 跑了采样。
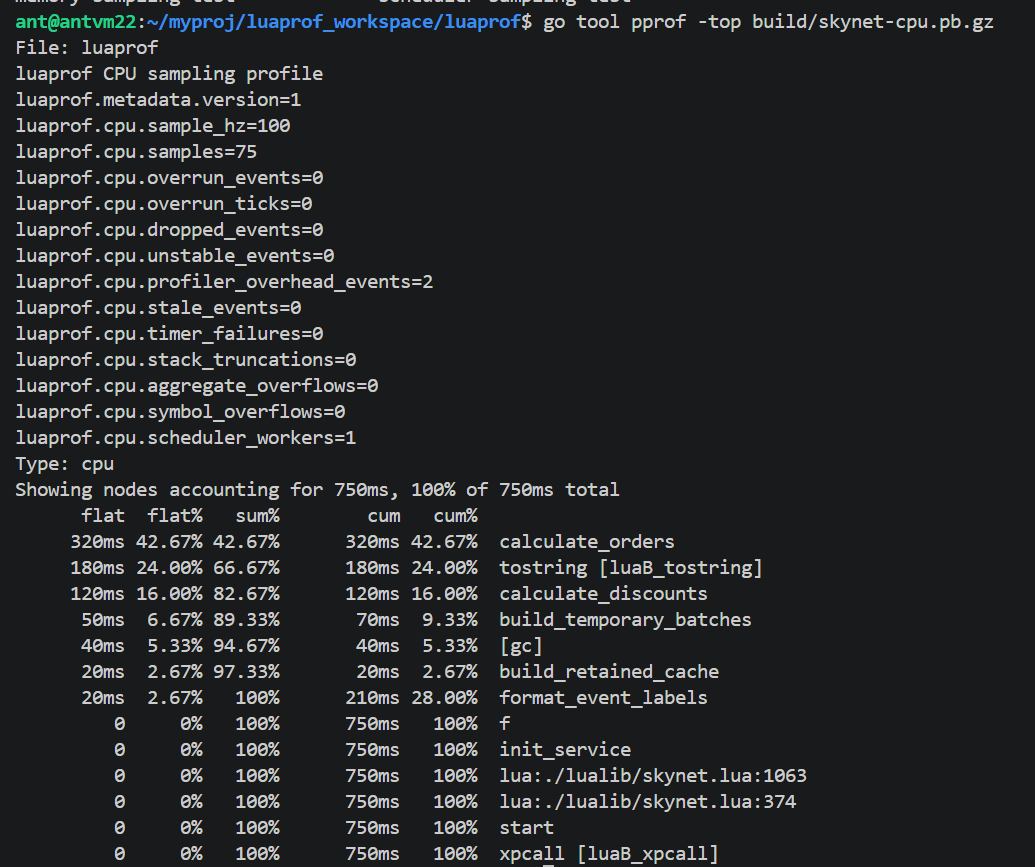
同样也可以按行去归因,只需要改一下 pprof 的参数,这里不展开了。
3、内存采样支持传统的每线程一个 lua vm 的
运行示例:
1
2
make example-thread-vm
go tool pprof -sample_index=alloc_space -top build/thread-vm-heap.pb.gz
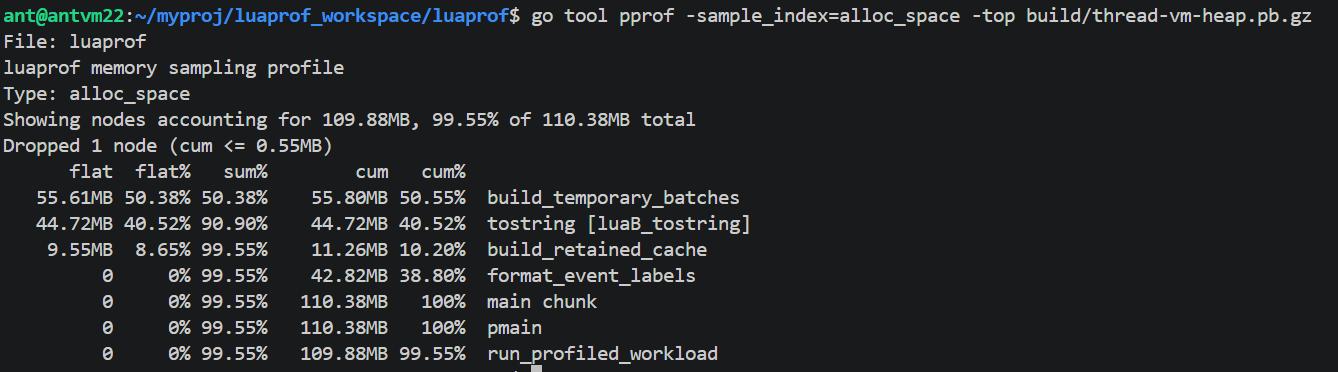
也可以按行去归因,不过同样会显得过细:
1
go tool pprof -sample_index=alloc_space -top -lines build/thread-vm-heap.pb.gz
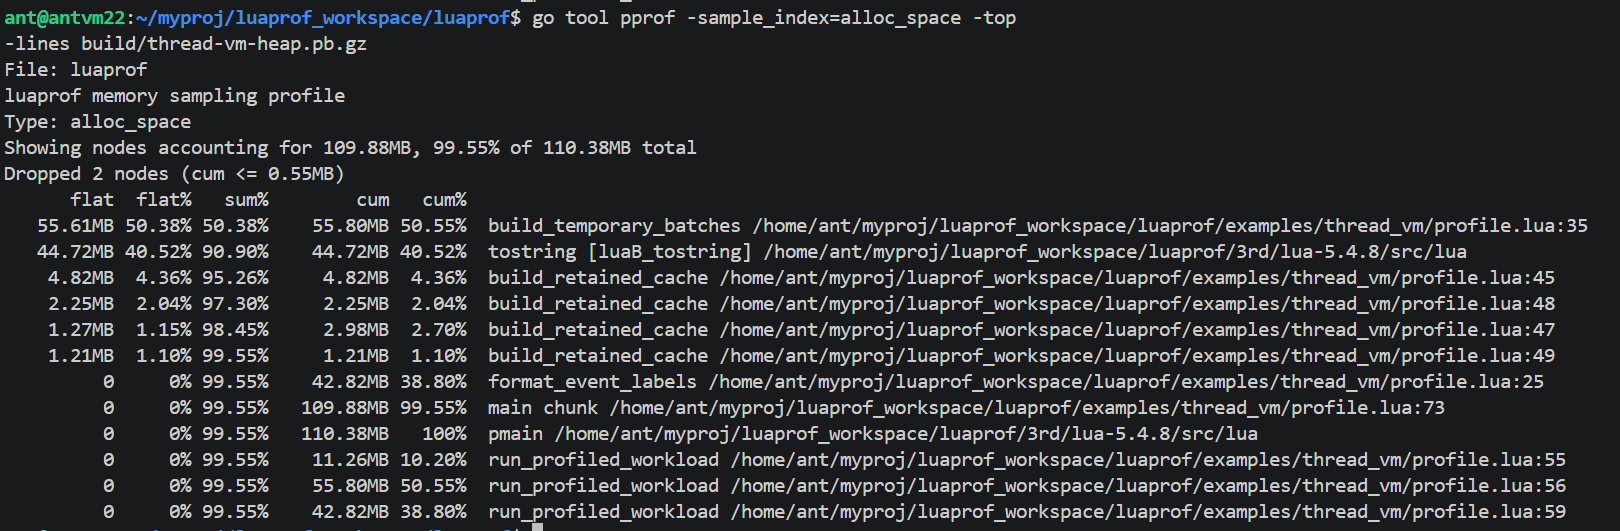
alloc_space 只是一个维度,我们也可以使用 alloc_objects 来观察分配的对象个数:
1
go tool pprof -sample_index=alloc_objects -top build/thread-vm-heap.pb.gz
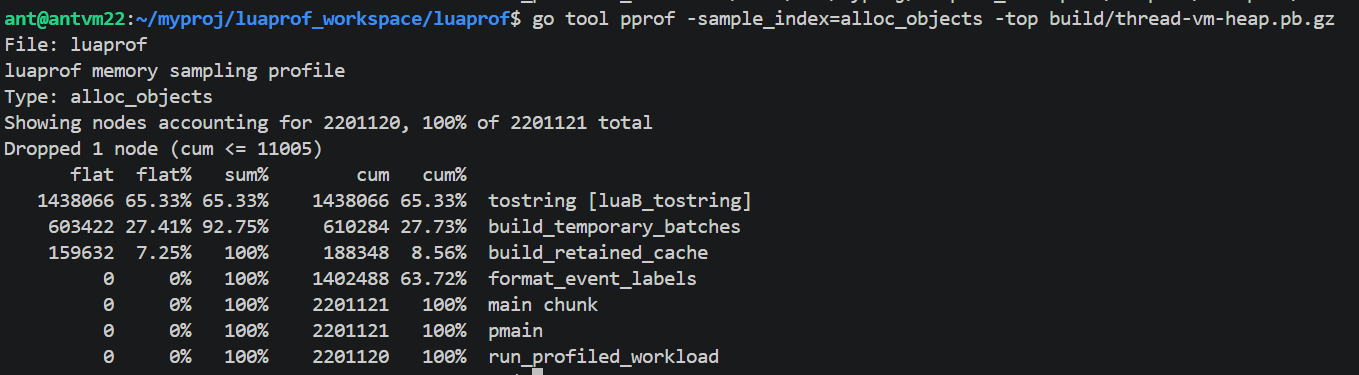
这个 example luaprof/blob/master/examples/thread_vm/profile.lua 在做 heap profiling 的时候打开了 track_free 开关:
1
2
3
4
local memory_recorder = assert(profile.memory.start {
	sample_bytes = 64 * 1024,
	track_free = true,
})
所以额外统计了 inuse_space 和 inuse_objects,inuse 意即还在使用中的内存,即 profiling 开始后捕捉到的 alloc - free 的内存。
1
go tool pprof -sample_index=inuse_space -top build/thread-vm-heap.pb.gz
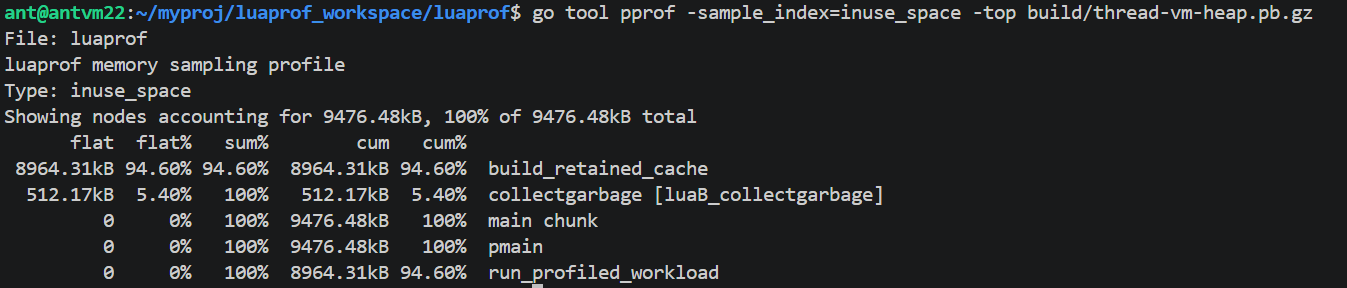
同理也可以生成 inuse_objects,这里不展开了。
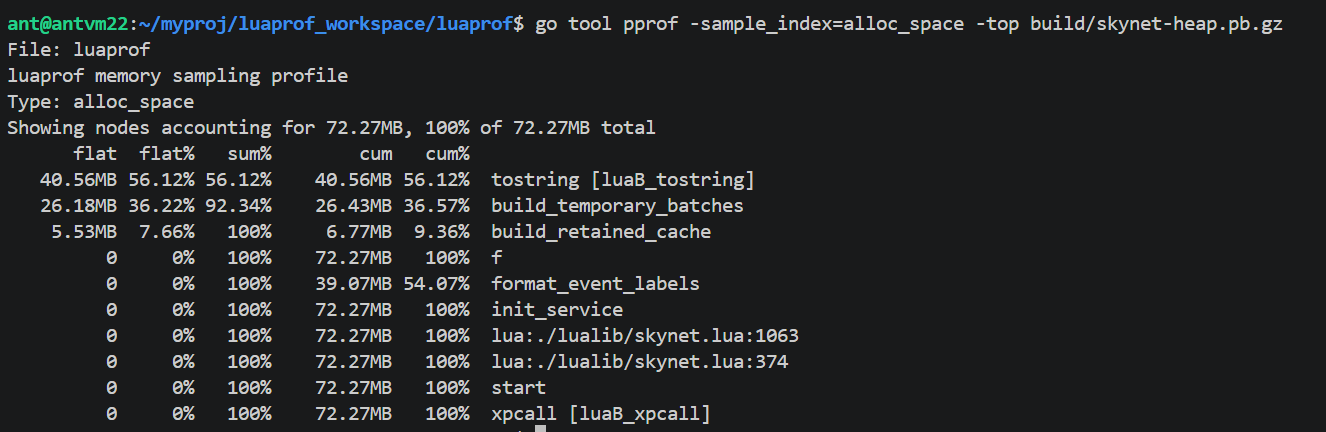
4、内存采样也支持 skynet 按 service 采样
运行示例:
1
2
make example-skynet
go tool pprof -sample_index=alloc_space -top build/
4.3 主要设计
cpu 采样原理
heap 采样原理
如何采集 cfunction
前面提到的 pLua 不能很好的采集 cfunction,那我们这里是如何解决的呢?
1、用的是线程级 timer,timer 到期时 handler 会安全的累计 tick ,并设置标志位。
2、等执行权回到 lua 安全点时,会立即取出调用栈,此时 cfunction 还在栈里(等待弹出),可以相对稳定得获得到样本并进行累加。
如何解决 skynet 的 service 与 worker 线程不一一对应的问题
skynet 的 worker 线程并不与 service 绑定,所以每个 service 都可能被任意 worker 线程运行,
异步信号中只做有限操作
signal handler 不直接遍历 lua 调用栈。它读取通过原子字段和版本检验发布的 execution slot,取得 lua_State *、Lua/C/GC/host 状态和当前 CFunction 等小型信息,写入固定 event ring,再请求 VM 在安全点处理。
原因是 signal 可以打断任意 VM 操作,此时栈或其他内部数据结构可能正处于修改过程。延迟到安全点访问栈,能避免从异步信号中读取不稳定的 VM 结构。
Lua、C、GC 和 host 状态
线程级 timer
使用实际 cpu 时间消耗来计时,而不是墙钟(wall time),避免 sleep 也被采样。
安全点
异步记录状态,安全点捕获栈。
cfunction 保留信号时刻的 leaf
skynet 按 service 做 profiling
skynet 底层起了若干个 worker 线程,service 运行时可能在其中任一个 worker,所以实现上每个 worker 线程都设了 thread timer,timer 到期的时候会判断当前线程是否运行着需要采样的 service,如果不是,则跳过 handle。
pprof 格式
结果保存为 pprof 格式 google/pprof ,除了消耗信息,也把采样有关的信息附带上了,比如 overrun 。直接用 pprof 查看,可以生成 txt 报告,也可以生成 svg 报告,还可以生成火焰图。
pprof google/pprof/blob/main/proto/README.md 格式的核心是把 “哪条调用栈上观察到多少消耗” 记录下来,再附上函数、源码位置和指标含义。pprof 根据这些关联数据做汇总,就能展示函数排行、源码行、调用关系和火焰图。
example 里面的 thread-per-vm.pb.gz 就是用 protobuf 编码的标准 profile 数据,再用 gzip 压缩。
具体记录的内容可以分成以下几部分:
| 数据 | 记录什么 | 用途 |
|---|---|---|
sample_type | 指标名称和单位,如 samples/count、cpu/nanoseconds | 解释数值的含义 |
sample | 调用栈,以及这条栈对应的一组数值 | 核心统计数据 |
location | 栈上的位置,包括函数、源码行;也可包含机器地址 | 把栈关联到代码位置 |
function | 函数名、源码文件名、函数起始行 | 展示函数和源码信息 |
mapping | 可执行文件或动态库的地址范围、文件名、构建标识 | 支持原生代码地址解析 |
label | 样本附带的字符串或数值标签 | 按线程、请求等维度过滤和分组,具体取决于采集器 |
| profile 元信息 | 采集时间、持续时长、采样周期、默认指标、注释等 | 解释采集背景和质量 |
它的存储方式不是每个样本都重复写一遍完整函数名,而是通过 id 和索引关联。可以这样类比:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
指标定义:
  [sample/count, cpu/nanoseconds]

函数表:
  F1 -> main, 文件 demo.lua
  F2 -> calculate, 文件 demo.lua

位置表:
  L1 -> F1, 第 10 行
  L2 -> F2, 第 42 行

样本:
  调用栈 = [L2, L1]           # 叶子函数在前
  数值   = [3, 30000000]      # 3 个样本,30ms CPU
这条记录表达的是:在 main->calculate 这条调用栈上,累计观察到了 3 个样本,对应 30ms 的 cpu 权重。
相同调用栈的样本可以合并,将各项数值分别相加。字符串也统一放在字符串表中,其他结构通过索引引用,因此大量重复栈仍能比较紧凑地保存。
cpu 和 heap 使用同种结构,主要区别在于数值代表什么。 cpu 可以记录样本数和 cpu 时间;heap 可以记录累计分配对象数、累计分配字节数、仍存活对象数、仍存活字节数。一个样本可以同时携带多项指标, -sample_index 决定报告使用哪项指标作为权重。
我们导出的 luaprof.cpu.overrun_ticks 则属于 profile 的 comment 注释:它是字符串表中的一段文本,由 profile 引用。pprof -top 会打印这些注释,但并不理解 overrun_ticks 的统计含义。
4.4 细节处理
长时间运行的 cfuntion 能否被正常采样到
即使运行一个长时间的 cfunction,也能采样到它。因为 timer 信号到的时候,handler 会计数的,退出 cfunction ,马上就会进入安全点,此时是能抓到栈,并对这个 cfunction 进行归因的。
关于 overrun
overrun 指 cpu timer 已经多次到期,但系统只送达了一次采样信号,其余到期次数没有独立的执行现场。
luaprof 的处理原则是:记录这些缺失次数,但不把它们补算到某个函数上。
Linux 的 POSIX timer 对每个 timer 最多保留一个待处理。这个信号尚未送达时,timer 再次到期,就累计 overrun;送达时通过 siginfo_t.si_overrun 告诉我们额外到期了多少次。即使使用实时信号,也有这个限制的。 linux timer 语义
例如,配置 1000HZ,即每消耗 1ms 线程 cpu 时间采样一次:
1
2
3
4
5
线程 CPU 时间   1ms       2ms       3ms       4ms
timer 到期       ↓         ↓         ↓         ↓
通知状态         信号待处理,后续到期累计 overrun
最终送达                                      一次信号
                                              si_overrun = 3
这里有4次到期,但只有一次信号送达。
常见成因包括:
- 信号暂时被屏蔽:线程继续消耗 CPU,timer 继续到期,但无法进入 handler。
- 内核到期检查和信号送达有延迟:CPU timer 的处理涉及内存 tick 等路径,配置间隔很短时,一次检查可能跨过多个周期。
- 信号处理期间继续消耗 CPU:同一个信号通常在 handler 执行期间被屏蔽;频率过高或处理过慢会增加积压机会。
overrun 在 example 里并不多,但在实践中会比较多,所以不要把频率调得太高,当前默认的 sample_hz 是 100,已经挺合适了。